Cuando un dato que protege hoy puede perjudicar mañana: la deuda del dato y el riesgo de sesgo algorítmico
Del dato de protección al dato de exclusión
La modificación introducida por el Real Decreto 813/2026, de 7 de octubre, en el régimen de las cuentas de pago básicas plantea una cuestión que va mucho más allá de facilitar a una persona vulnerable el acceso a un servicio financiero esencial.
El Real Decreto modifica el Real Decreto 164/2019 para facilitar la acreditación de la vulnerabilidad económica necesaria para acceder gratuitamente a una cuenta de pago básica. Cuando no se dispone de determinada documentación, puede aportarse un informe de los servicios sociales y, en determinados supuestos, pueden proporcionar información determinadas entidades sin ánimo de lucro del Sistema Nacional de Acogida o del Tercer Sector de Acción Social. La entidad bancaria debe tener en cuenta esa información al decidir sobre la apertura de la cuenta básica gratuita.
La finalidad es claramente positiva: evitar que una persona en situación de vulnerabilidad quede excluida del sistema financiero por no poder acreditar documentalmente su situación.
Pero precisamente esa protección genera una pregunta que el legislador debería hacerse con la misma intensidad:
¿Qué ocurre con ese dato cuando la persona deja de ser vulnerable?
Porque un dato que hoy permite ejercer un derecho puede convertirse mañana, si se conserva, se reutiliza o se cruza con otros datos, en un factor que perjudique el ejercicio de otro derecho o el acceso a una oportunidad.
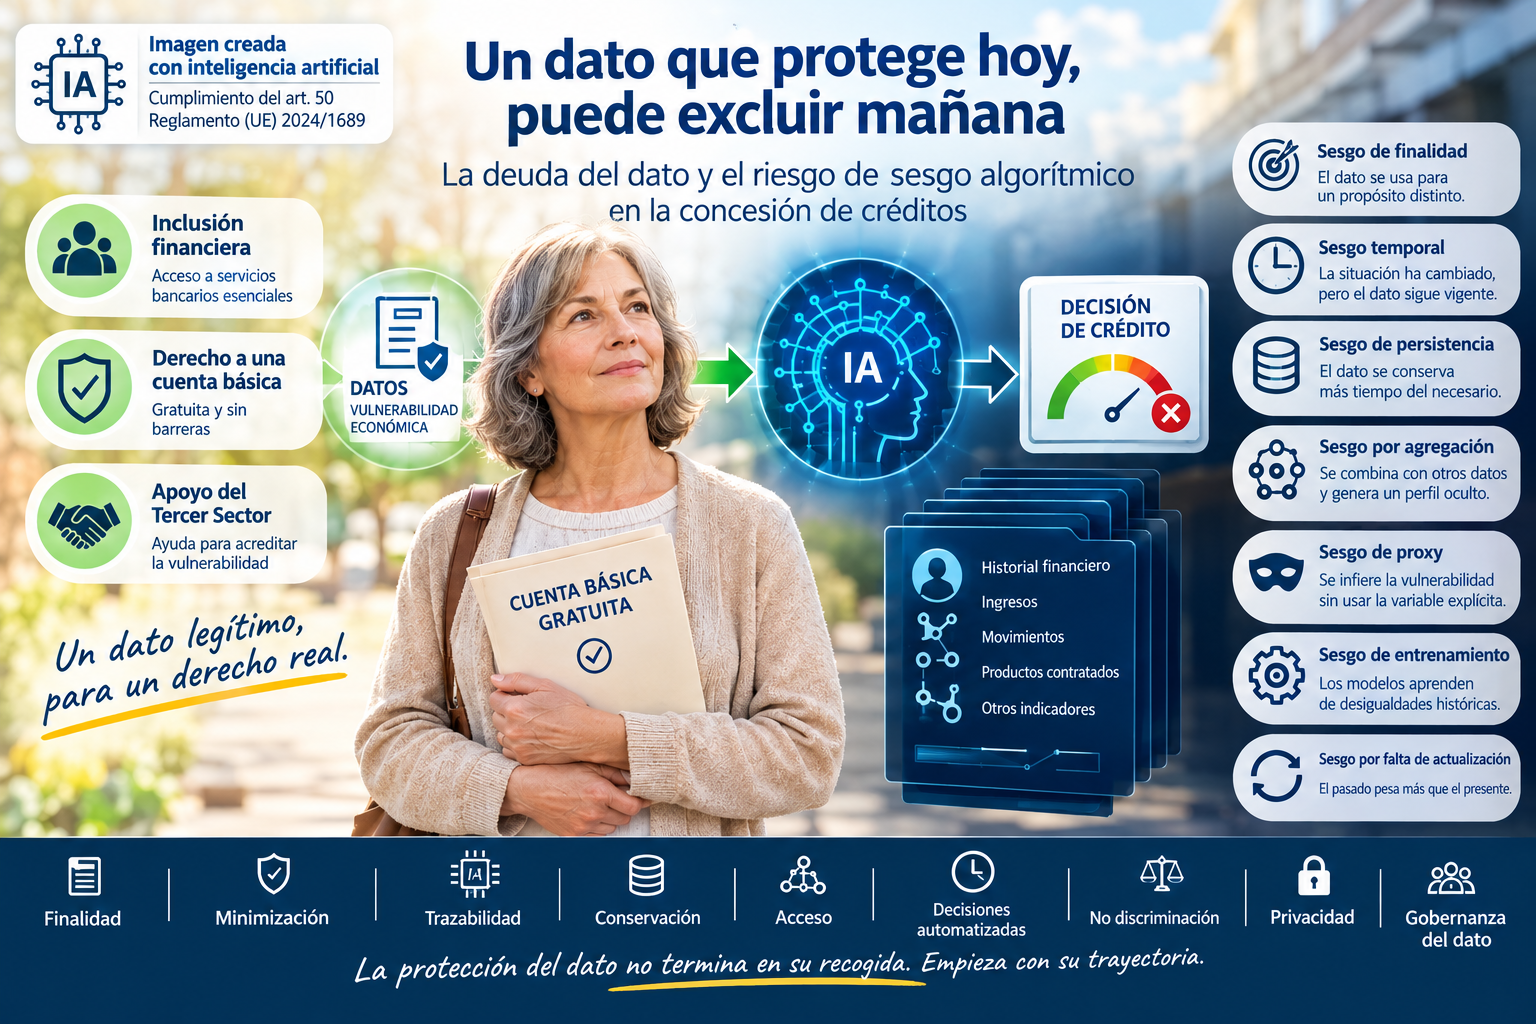
Esta es una de las manifestaciones más interesantes de lo que puede denominarse la deuda del dato.
1. El dato no es bueno o malo: depende de su finalidad
Un error frecuente consiste en pensar que determinados datos son intrínsecamente positivos o negativos, pero no es así.
Un dato puede ser perfectamente legítimo, necesario y beneficioso para una finalidad concreta y, sin embargo, resultar inadecuado o incluso perjudicial para otra.
La información de que una persona se encuentra en situación de vulnerabilidad económica puede ser necesaria para que pueda beneficiarse de una cuenta de pago básica gratuita.
Pero esa misma información puede ser problemática si, años después, se utiliza para valorar:
- su capacidad para obtener un préstamo,
- su solvencia,
- el riesgo asociado a una operación,
- el precio de un producto financiero,
- la probabilidad de impago,
- su perfil como cliente,
- o cualquier otra decisión automatizada o semiautomatizada.
El problema, por tanto, no está necesariamente en recoger el dato, sino en lo que ocurre con él después.
El RGPD establece precisamente que los datos deben recogerse para fines determinados, explícitos y legítimos y no deben ser tratados posteriormente de manera incompatible con esos fines. También exige que sean adecuados, pertinentes y limitados a lo necesario para la finalidad correspondiente.
Por eso, la pregunta fundamental no debería ser únicamente: ¿puede el banco conocer este dato? sino ¿para qué puede utilizarlo el banco, durante cuánto tiempo, quién puede acceder a él y qué decisiones puede llegar a alimentar?
2. El primer sesgo puede aparecer antes de que exista ningún algoritmo
Cuando hablamos de sesgo algorítmico solemos imaginar inmediatamente una inteligencia artificial que toma una decisión injusta. Pero el algoritmo puede ser solamente el último eslabón de una cadena de decisiones anteriores.
El verdadero origen del sesgo puede encontrarse mucho antes. Por ejemplo:
1. Recogida del dato
Una persona acredita su vulnerabilidad económica para acceder a una cuenta básica gratuita.
↓
2. Registro
La información queda incorporada a los sistemas de información de la entidad.
↓
3. Conservación
El dato permanece almacenado durante un determinado periodo.
↓
4. Integración
Puede quedar relacionado con otros datos financieros del cliente.
↓
5. Clasificación
El sistema puede incorporar a la persona a determinados perfiles o segmentos.
↓
6. Modelización
Algunos de esos datos pueden terminar formando parte de modelos estadísticos o algorítmicos.
↓
7. Decisión
Un sistema puede utilizar información histórica para estimar el riesgo futuro.
El sesgo, por tanto, no tiene necesariamente su origen en el algoritmo; puede estar en la selección de los datos que llegan al algoritmo. Y esta distinción es esencial.
Un algoritmo puede ser matemáticamente correcto y producir una decisión injusta porque los datos con los que trabaja contienen una historia que ya no representa a la persona.
3. El problema de la vulnerabilidad que deja de existir
Imaginemos un caso sencillo.
Una persona atraviesa durante dos años una situación económica complicada. Con ayuda de una entidad del Tercer Sector acredita su vulnerabilidad y obtiene una cuenta de pago básica gratuita.
Cinco años después, su situación ha cambiado completamente.
Tiene empleo estable, ingresos superiores a los que tenía anteriormente, patrimonio y capacidad suficiente para solicitar financiación.
Solicita entonces un préstamo.
El banco dispone de abundante información histórica sobre ella.
La pregunta es:
¿Forma parte de esa información su antigua situación de vulnerabilidad?
Si forma parte de ella, aparece una segunda pregunta:
¿Puede influir directa o indirectamente en el sistema de evaluación de riesgo?
Y aparece una tercera, todavía más importante:
¿Puede la persona saber que esa circunstancia histórica ha influido en la decisión?
Aquí encontramos el verdadero problema.
La vulnerabilidad era real cuando se acreditó.
Pero puede ser irrelevante cuando se solicita el crédito.
El dato no es necesariamente falso.
Lo que puede haber quedado obsoleto es su significado.
Por eso, la exactitud del dato no siempre significa que el perfil construido a partir de él sea correcto.
Un dato puede ser verdadero y, sin embargo, conducir a una conclusión falsa sobre la persona.
4. La deuda del dato: cuando el pasado se convierte en destino
Esta situación puede definirse como deuda del dato.
La deuda aparece cuando una información generada para resolver un problema concreto permanece en los sistemas y comienza a tener efectos mucho después de que haya desaparecido la circunstancia que justificó su recogida.
Es una especie de memoria institucional.
El sistema recuerda:
«Esta persona fue vulnerable».
Pero quizá ya no recuerda, o no pondera suficientemente:
«Esta persona dejó de serlo».
Aquí aparece una asimetría especialmente peligrosa.
El sistema financiero puede ser extraordinariamente preciso para recordar el pasado, pero mucho menos capaz de comprender el cambio.
Y una persona no es una fotografía.
Es una trayectoria.
Por eso:
La trazabilidad del dato debe incorporar no solo su origen, sino también su contexto temporal
No debería bastar con saber que un dato es verdadero.
Hay que saber:
cuándo era verdadero, para qué se obtuvo, qué significado tenía entonces y si sigue siendo pertinente para la decisión que ahora se pretende adoptar.
5. ¿De dónde pueden venir los sesgos?
Los sesgos pueden aparecer en diferentes puntos de la cadena.
A. Sesgo de finalidad
El dato se recogió para garantizar un derecho, pero posteriormente se utiliza para una finalidad distinta.
Ejemplo:
acceso a una cuenta básica → evaluación de riesgo crediticio.
El problema no es necesariamente que ambas actividades pertenezcan al ámbito financiero.
El problema es que la finalidad protectora inicial no convierte automáticamente el dato en apropiado para cualquier otra decisión financiera.
B. Sesgo temporal
El dato describe correctamente una situación pasada, pero la persona ha cambiado.
Una vulnerabilidad de 2026 no necesariamente describe la solvencia de 2031.
La fecha de un dato puede ser tan importante como su contenido.
Un sistema que utiliza información histórica debería distinguir entre:
- situación actual;
- situación pasada;
- duración de la situación;
- evolución posterior;
- y circunstancias que demuestran que aquella situación ha desaparecido.
C. Sesgo de persistencia
El dato permanece en los sistemas más tiempo del que resulta necesario para la finalidad que justificó su recogida.
Cuanto más tiempo permanece un dato, más posibilidades existen de que termine utilizándose para finalidades diferentes de aquellas para las que nació.
La cuestión no es solamente cuánto tiempo puede conservarse legalmente determinada información.
Es también:
¿Durante cuánto tiempo sigue siendo pertinente para cada finalidad?
D. Sesgo por agregación
El dato individual puede parecer inocuo.
Pero cuando se combina con otros puede adquirir un significado completamente diferente.
Por ejemplo:
vulnerabilidad acreditada + ingresos históricos + movimientos bancarios + domicilio + productos contratados + comportamiento financiero + otros indicadores.
El resultado puede generar un perfil que nunca fue declarado expresamente por la persona.
Aquí aparece una cuestión esencial de gobernanza:
El riesgo no está únicamente en cada dato, sino en las conclusiones que pueden obtenerse al combinarlos.
E. Sesgo de proxy
El sistema puede no utilizar directamente la variable «vulnerabilidad».
Pero puede utilizar otras variables que funcionen como sustitutos.
Por ejemplo, determinadas pautas de ingresos, productos financieros, movimientos o circunstancias socioeconómicas podrían permitir al modelo aproximarse indirectamente a una situación de vulnerabilidad.
Por eso no basta con preguntar:
«¿Utiliza el algoritmo el dato de vulnerabilidad?»
Hay que preguntar:
«¿Puede el algoritmo reconstruir o inferir esa vulnerabilidad a partir de otras variables?»
F. Sesgo de entrenamiento
Existe un riesgo adicional si los datos históricos utilizados por una entidad terminan formando parte de conjuntos de datos empleados para desarrollar, entrenar o validar modelos.
Un modelo puede aprender asociaciones históricas que fueron ciertas en determinado momento y reproducirlas posteriormente como si fueran reglas universales.
Así, una correlación histórica puede convertirse en una penalización futura.
La IA no solo puede aprender de nuestros errores; puede aprender también de nuestras desigualdades históricas y convertirlas en predicciones sobre nuestro futuro
G. Sesgo por ausencia de actualización
Este puede ser uno de los más peligrosos.
El sistema conserva el dato de que una persona fue vulnerable, pero no incorpora con el mismo peso el hecho de que posteriormente haya mejorado su situación.
En ese caso, el pasado tiene una presencia algorítmica mucho mayor que el presente.
La persona evoluciona.
El expediente no.
6. El Tercer Sector plantea una responsabilidad adicional
El RD 813/2026 incorpora expresamente al Tercer Sector en esta cadena de información, en supuestos determinados y previa autorización de las autoridades competentes en materia de servicios sociales. Su finalidad es facilitar la acreditación de la vulnerabilidad económica para acceder a una cuenta básica gratuita.
Esto es positivo desde el punto de vista de la inclusión.
Pero introduce una exigencia adicional:
la información proporcionada por una entidad social no debería perder su contexto cuando entra en el sistema financiero
No es lo mismo decir:
«Esta persona es vulnerable».
que decir:
«Esta persona fue considerada vulnerable, en esta fecha, para esta finalidad concreta y con estos elementos de acreditación».
La segunda información es mucho más rica y, paradójicamente, mucho más segura.
Porque conserva el contexto del dato.
El dato aislado etiqueta.
El dato contextualizado explica.
7. El verdadero objetivo debería ser la trazabilidad del dato
Aquí aparece una propuesta que va más allá de la simple protección de datos.
Deberíamos poder reconstruir la cadena de vida del dato:
origen → finalidad → consentimiento/base jurídica → acceso → conservación → modificación → combinación → utilización → decisión → supresión o bloqueo.
Y, cuando intervenga un sistema algorítmico:
dato de origen → variable utilizada → modelo → resultado → decisión → revisión humana.
Esto permitiría responder a una pregunta fundamental:
¿Por qué una persona ha recibido hoy una determinada decisión y qué papel ha desempeñado en ella un dato que se obtuvo años atrás para protegerla?
La trazabilidad no debería servir únicamente para investigar errores después de que se produzcan.
Debería servir para evitarlos antes de que el dato llegue al algoritmo.
8. El RGPD ya contiene parte de esta lógica
El RGPD exige limitación de la finalidad, minimización y exactitud de los datos. Además, contempla expresamente los riesgos de la elaboración de perfiles y de las decisiones automatizadas que pueden afectar significativamente a una persona. El artículo 22 establece, con sus excepciones y garantías, el derecho a no quedar sometido a determinadas decisiones basadas únicamente en tratamientos automatizados.
Y el propio marco europeo reconoce expresamente el problema de las decisiones automatizadas en ámbitos como la concesión de crédito y exige garantías frente a determinados riesgos.
Por tanto, la cuestión no consiste en esperar a que un algoritmo discrimine.
La cuestión es mucho anterior:
¿Qué datos estamos permitiendo que lleguen al algoritmo y con qué significado?
9. Una posible garantía: separar los datos de protección de los datos de decisión
El caso plantea una posible solución técnica y jurídica:
«Compartimentos de finalidad»
El dato utilizado para acreditar la vulnerabilidad debería quedar vinculado a la finalidad concreta para la que fue obtenido.
Eso no significa necesariamente que deba destruirse inmediatamente.
Significa que debería existir una barrera técnica y jurídica frente a su utilización automática para finalidades incompatibles.
Por ejemplo:
Datos de inclusión financiera
→ utilizados para determinar el derecho a una cuenta básica gratuita.
Datos de solvencia
→ utilizados para evaluar la capacidad actual de devolución de un crédito.
Y entre ambos sistemas debería existir una regla clara sobre:
- qué datos pueden pasar;
- cuáles no;
- durante cuánto tiempo;
- con qué justificación;
- quién autoriza el acceso;
- y cómo se registra ese acceso.
En otras palabras:
No basta con proteger el dato; hay que proteger también sus posibles usos futuros
10. La paradoja de la inclusión
Aquí aparece la paradoja que este Real Decreto permite visualizar.
La norma quiere evitar que una persona vulnerable sea excluida del sistema financiero.
Pero si no existe una adecuada gobernanza posterior del dato, podría producirse un efecto contrario en el futuro:
inclusión hoy → registro del dato → reutilización → perfilización → decisión algorítmica → exclusión mañana.
Evidentemente, el RD 813/2026 no establece que vaya a producirse esta cadena ni autoriza expresamente ese uso del dato. El problema que planteamos es preventivo: qué debe garantizarse para impedir que una información obtenida con una finalidad de protección termine generando efectos adversos en otro contexto.
Y esta distinción es fundamental.
No estamos diciendo que el algoritmo vaya a discriminar.
Estamos preguntando:
¿Tenemos garantías suficientes para impedir que pueda hacerlo utilizando información que nació para proteger?
11. La verdadera deuda del dato
La sociedad digital ha aprendido a preguntarse:
¿Tenemos derecho a recoger este dato?
Pero necesitamos formular una segunda pregunta:
¿Qué podrá hacerse con él dentro de 5 o 10 años?
Y una tercera:
¿Podremos demostrarlo?
La deuda del dato aparece cuando somos capaces de recoger información con enorme precisión, pero no somos capaces de controlar suficientemente su recorrido.
El problema no es tener memoria.
El problema es que una organización pueda recordar indefinidamente quién fuimos cuando nosotros ya hemos dejado de serlo.
Por eso, la gobernanza del dato debería incorporar una dimensión temporal:
Todo dato personal debería llevar consigo, además de su contenido, su contexto, su finalidad y su fecha de vigencia
Y cuando ese dato pueda alimentar una decisión automatizada, debería ser posible reconstruir su recorrido.
Conclusión: proteger a una persona no debería condenar su futuro
El caso de la vulnerabilidad económica es especialmente revelador porque muestra que el mismo dato puede tener dos caras.
En un momento determinado puede ser un dato de protección:
«Esta persona necesita ayuda y tiene derecho a una cuenta básica gratuita».
Años después, si se reutiliza sin contexto, podría convertirse en un dato de riesgo:
«Esta persona tuvo dificultades económicas».
La primera afirmación permite ejercer un derecho.
La segunda puede influir negativamente en una oportunidad.
Entre ambas no ha cambiado necesariamente el dato.
Ha cambiado la finalidad.
Y ahí reside el verdadero riesgo.
El mayor peligro del dato no siempre está en que sea falso. Puede estar en que sea verdadero, permanezca para siempre y termine utilizándose fuera del contexto que le daba sentido
La inteligencia artificial añade una nueva dimensión al problema: puede encontrar correlaciones que ningún operador humano había previsto, transformar circunstancias históricas en variables predictivas y convertir decisiones aparentemente neutrales en mecanismos de clasificación.
Por eso, la respuesta no puede limitarse a auditar el algoritmo.
Hay que auditar la cadena completa:
qué dato se recoge → por qué se recoge → quién lo aporta → quién lo conserva → cuánto tiempo → con qué otros datos se combina → quién puede utilizarlo → qué modelo lo procesa → qué decisión produce.
Esta debería ser una de las próximas fronteras de la protección de datos:
pasar de proteger el dato a proteger la trayectoria del dato.
Porque en una sociedad gobernada cada vez más por datos y algoritmos, la verdadera libertad no consiste solamente en decidir qué información entregamos hoy; consiste también en impedir que esa información determine injustamente quién podremos ser mañana.